El 13 de octubre, el blog de ingeniería de Anthropic publicó el diseño de Scion, el sistema de control de versiones interno con el que reemplazó Git en todo su monorepo en solo cinco meses. El motivo de fondo no es una moda: conforme los agentes de Claude empezaron a escribir cada vez más código, la infraestructura construida para humanos se convirtió en el cuello de botella del desarrollo. La migración la completó un equipo de siete personas, que además construyó Antique, la herramienta de revisión de código que acompaña al sistema. En esta nota repasamos qué es Scion, cómo funciona, qué ventaja real ve una gran empresa en este diseño y por qué, dicho sin rodeos, **a los desarrolladores y empresas estándar no les serviría**.
El número que lo explica todo
En mayo de 2026, Anthropic integraba unos 2.500 cambios de código al día en su monorepo. Para septiembre ya eran más de 30.000 al día: doce veces más en cuatro meses. La empresa no espera que ese crecimiento se frene; su diagnóstico es que la demanda latente de integrar código es prácticamente infinita, porque cada cuello de botella que se elimina provoca de inmediato aún más código. Ese será también el marco de esta nota: no es un juicio contra Git, es la primera descripción pública y completa de cómo cambia el desarrollo cuando la mayoría del código lo escriben agentes.
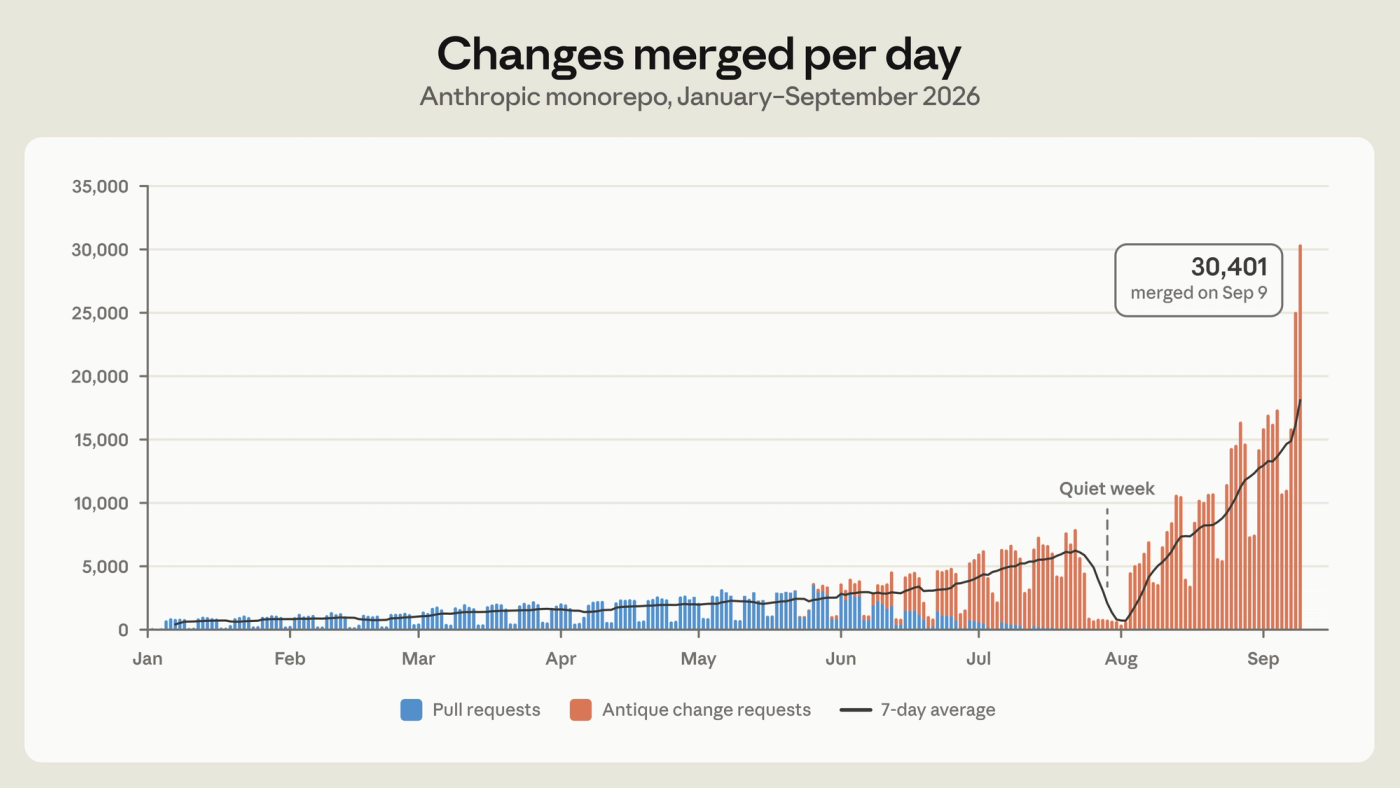
Cambios integrados al día en el monorepo de Anthropic, de enero a septiembre de 2026. Imagen: Anthropic.
Por qué Git dejó de aguantar
Git es un sistema descentralizado: cada clon es un repositorio completo y autosuficiente, capaz de calcular diffs, leer el historial y cambiar de revisión estando fuera de línea. Para casi todos los repositorios del mundo ese diseño es correcto, y es buena parte del motivo por el que Git se volvió el estándar. El problema de Anthropic son las cifras: la historia de su rama main ronda los 100 GB, una copia de trabajo comprimida supera los 25 GB, y por CI se ejecutan del orden de 25 millones de checkouts de código al día, que de manera ingenua representarían más de 600 petabytes de tráfico Git diarios.
Antes de construir un sistema nuevo, agotaron las soluciones de manual: clones superficiales, checkouts parciales, promisor remotes, instantáneas del repositorio en almacenamiento de objetos y espejos internos. Al pico llegaron a operar varios cientos de espejos de Git. Eso compró tiempo, pero se volvió cada vez más difícil de operar conforme subía el ritmo de integraciones: las instantáneas quedaban más atrás de la punta de main entre refrescos, y mantener operaciones que dependen del historial, como diff y blame, sobre clones parciales exigía más y más cuidado.
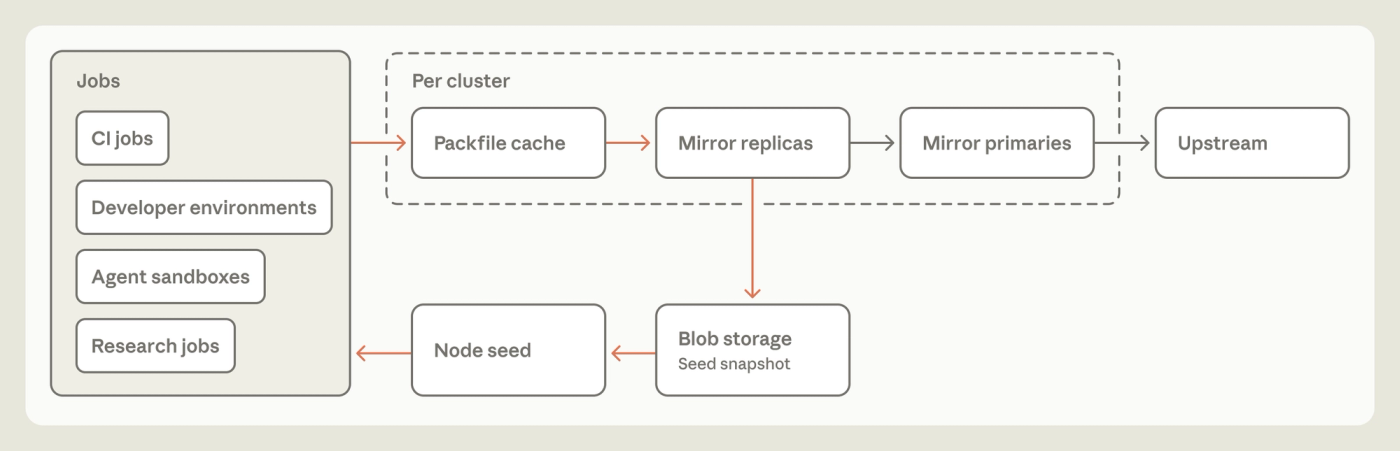
El esquema típico de escalado de checkouts de Git con el que Anthropic intentó sostener su monorepo. Imagen: Anthropic.
La observación que originó Scion es casi de sentido común: estaban usando Git como un sistema centralizado con una única copia autoritativa, pero casi todos sus clientes eran agentes y trabajos que están en línea por definición. Las propiedades que hacen excelente a Git para trabajo distribuido y fuera de línea eran las que, a su escala, le impedían crecer. La pregunta que se hicieron fue: si se diseñara desde cero un control de versiones sabiendo que los agentes siempre están conectados, ¿cómo se vería?
Los principios del rediseño
Los autores no partieron de cero: reconocen los antecedentes de Piper (Google) y Sapling (Meta) — en particular Mononoke, el servidor de Sapling, pionero de técnicas como el modelo de datos Bonsai que Scion aprovecha. Sobre esas lecciones, el diseño se desmarca de Git en seis principios:
- Clientes siempre en línea. Git asume que cada cliente puede estar offline y necesita una copia completa del repositorio. En Scion, el cliente y los protocolos están diseñados en torno a un servidor siempre alcanzable, del que se baja lo necesario al momento.
- Asimetría servidor-cliente. En Git, cualquier clon puede actuar como servidor completo. En Scion, el servidor responde preguntas de historial y blame, crea commits, rebases y merges; el cliente mantiene una caché local acotada, compone los archivos de la copia de trabajo en disco y casi nada más.
- El control de versiones como servicio. Las mismas consultas que usa el cliente están expuestas por API, así que muchos trabajos de CI y herramientas internas — como los pipelines automatizados de bisect y revert de la empresa — no necesitan ningún repositorio local.
- Todo horizontalmente escalable. No existe copia materializada del repositorio en ningún sitio, ni siquiera en el servidor, y no hay equivalente de los packfiles: no hay mantenimiento del repositorio que planificar.
- Commits baratos, incrementales y sin locks. Todo commit, rebase o merge ocurre en el servidor, así que no hay nada que empujar; el costo de cada operación escala con el tamaño del cambio, no del repositorio. Los refs (ramas y etiquetas) se desalientan, salvo
mainy las ramas de release, porque el estado global que todos los servidores deben acordar es un problema de escalado latente. - La copia de trabajo es opcional, y sparse por diseño. Un trabajo de CI que necesita el diff entre un commit y su base puede pedírselo al servidor, y muchos flujos de escritura funcionan enteramente por API. Los checkouts son sparse (solo los directorios pedidos) y virtualizados (archivos materializados al leerlos): el cliente solo paga por lo que realmente usa.
Cómo funciona por dentro
La unidad de trabajo de Scion es el changeset, una entrada en un registro de escritura anticipada. Conserva lo esperable de un commit de Git con una diferencia estructural: en lugar de apuntar al árbol del repositorio, lista los archivos que cambiaron respecto a su primer padre, con punteros dirigidos por contenido hacia los contenidos comprimidos en blob storage. Crear un changeset cuesta proporcional al cambio y está disponible en todo el sistema de inmediato, sin packfiles que empaquetar, sin locks ni coordinación entre servidores.
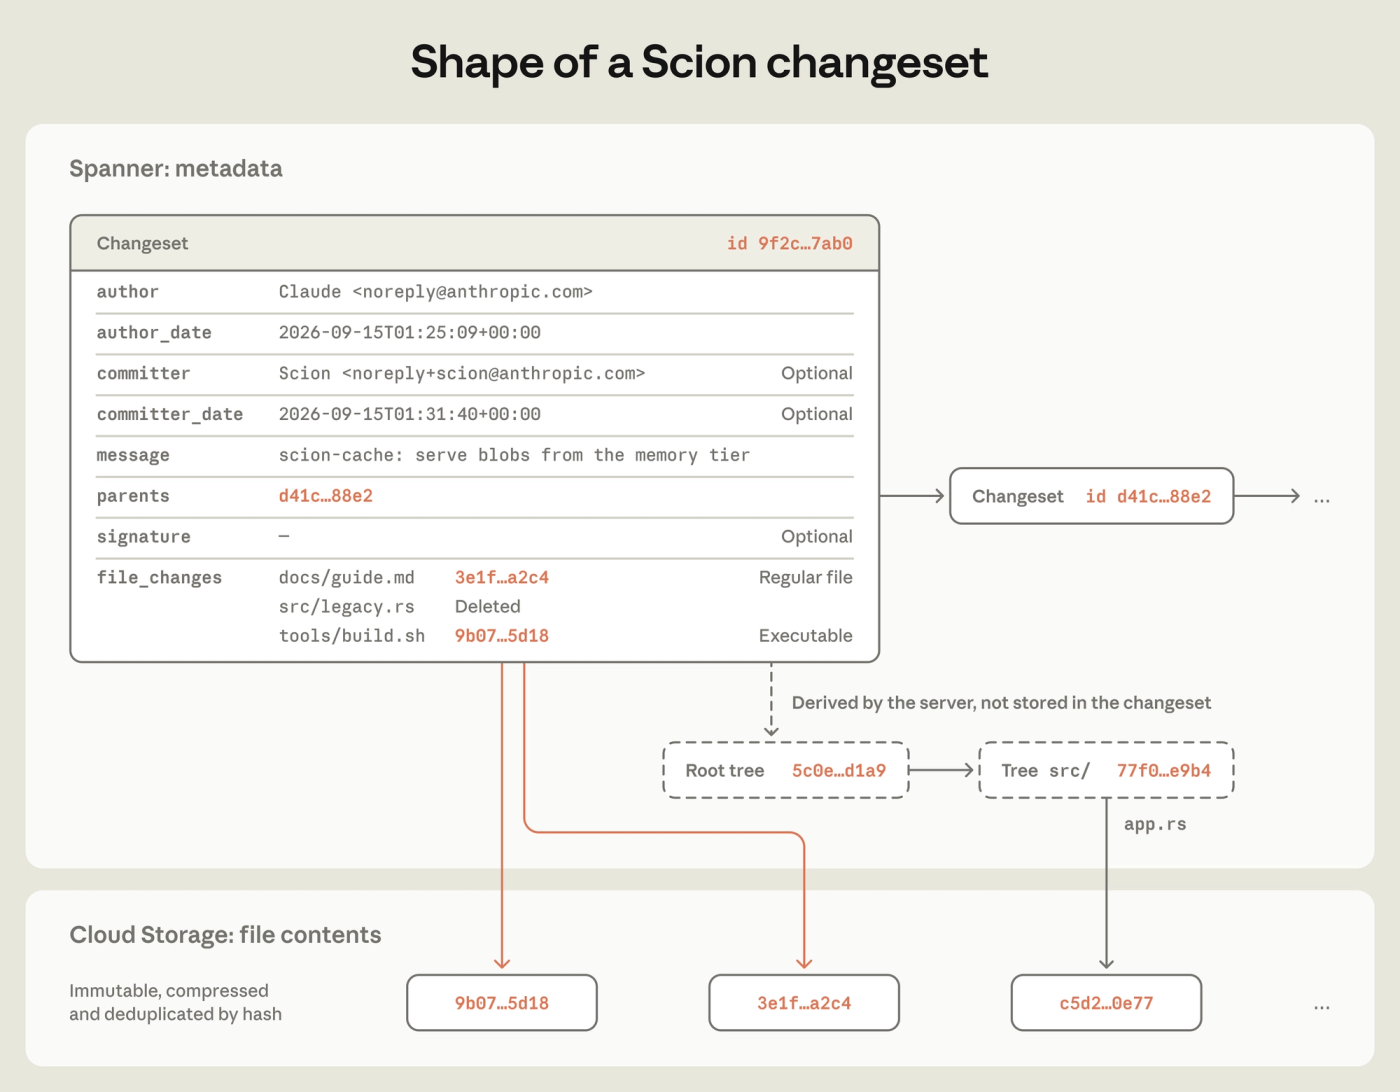
La forma de un changeset de Scion. Imagen: Anthropic.
Un changeset por sí solo no puede responder rápido quién editó una línea o qué commits afectaron a un archivo. Para eso, el sistema deriva estructuras adicionales — blame por archivo, historial por ruta, skip lists para el grafo de commits — mediante un mecanismo genérico y recursivo: cada tipo de dato derivado se calcula a partir de los valores de los padres del changeset. El beneficio es triple: agregar tipos nuevos es trivial, se puede decidir si se materializan ahora o después, y como el cliente nunca ve sus interioridades, pueden optimizarse sin romper herramientas.
La capa de cliente, scn, conversa con un demonio por nodo, scion-daemon, que guarda los objetos de esa máquina: los trabajos de un mismo nodo reutilizan la mayoría de los objetos entre sí. Cada demonio parte de una instantánea refrescada periódicamente y solo habla con los servidores de caché de árboles y blobs de su región, scion-cache; estos entregan los objetos directamente desde memoria, en el formato de disco que el demonio consume, sin calcular los objetos que faltan ni comprimir deltas. Cuando a una caché le falta algo, lo pide a los servidores autoritativos scion-server, que leen de Spanner o del almacenamiento en la nube según haga falta. Las tres capas responden a los mismos RPC, así que el cliente ignora la topología de cachés, aunque la jerarquía se aplica de forma estricta para aislar dominios de fallo.
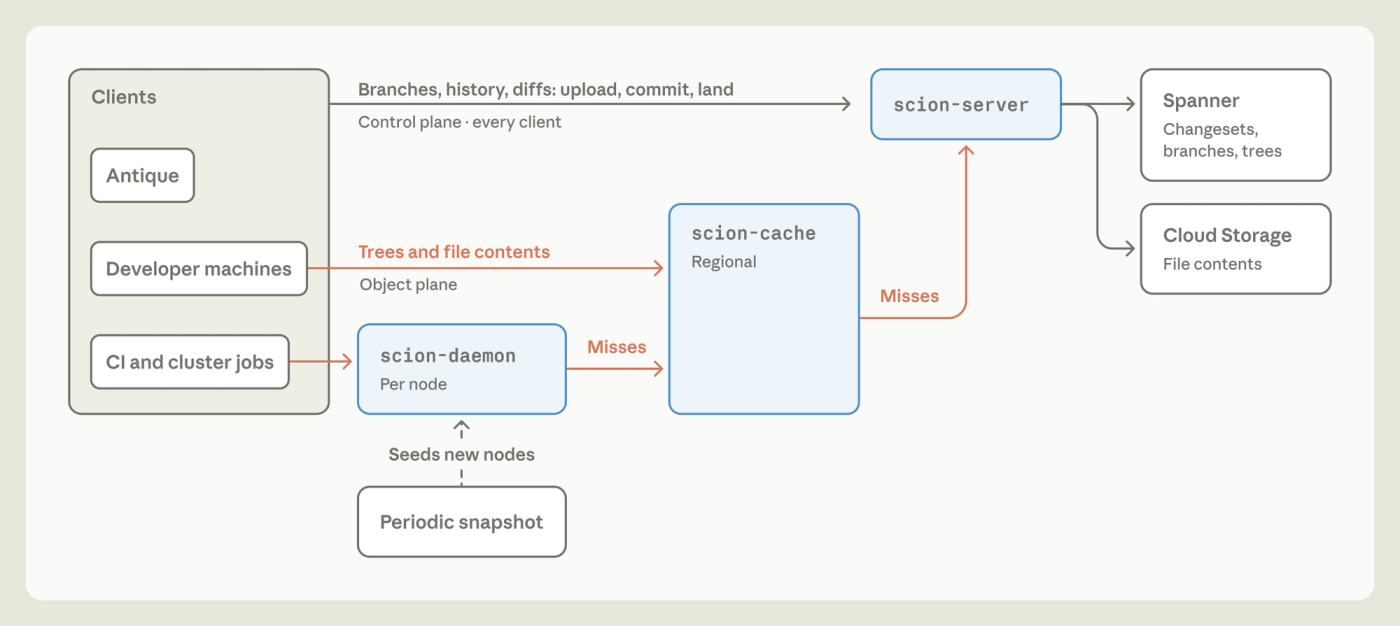
La arquitectura de checkouts de Scion en tres niveles. Imagen: Anthropic.
El resultado económico es contundente: la infraestructura de Scion es 200 veces más pequeña, en CPU y memoria, que la flota de espejos de Git que reemplazó. Cada nivel del sistema mantiene una tasa de acierto en caché superior al 99 %, sin estado de larga duración, y los checkouts de CI e investigación pasaron de minutos a segundos: solo el CI liberó un 25 % de capacidad de CPU de la flota.
El giro meta: los agentes construyeron la salida del problema que ellos causaron
La ironía la subraya el propio post: la capacidad de Claude de escribir código fue la que puso a la empresa en este problema, y la que permitió salir de él. Al arrancar el proyecto se liberaron internamente Claude Mythos Preview y Claude Tag, que a la vez multiplicaron la necesidad de Scion y aceleraron su construcción. El ejemplo favorito del equipo: la primera versión del pipeline de ingestión Git-Scion estaba escrita a mano y en teoría era buena, hasta que pidieron a un prototipo temprano de Claude Mythos Preview reescribirla entera, sin más instrucciones; el resultado consumía 20 veces menos memoria y era cuatro veces más rápido, preservando todas las invariantes implícitas del orden de ingestión y de las estructuras de datos.
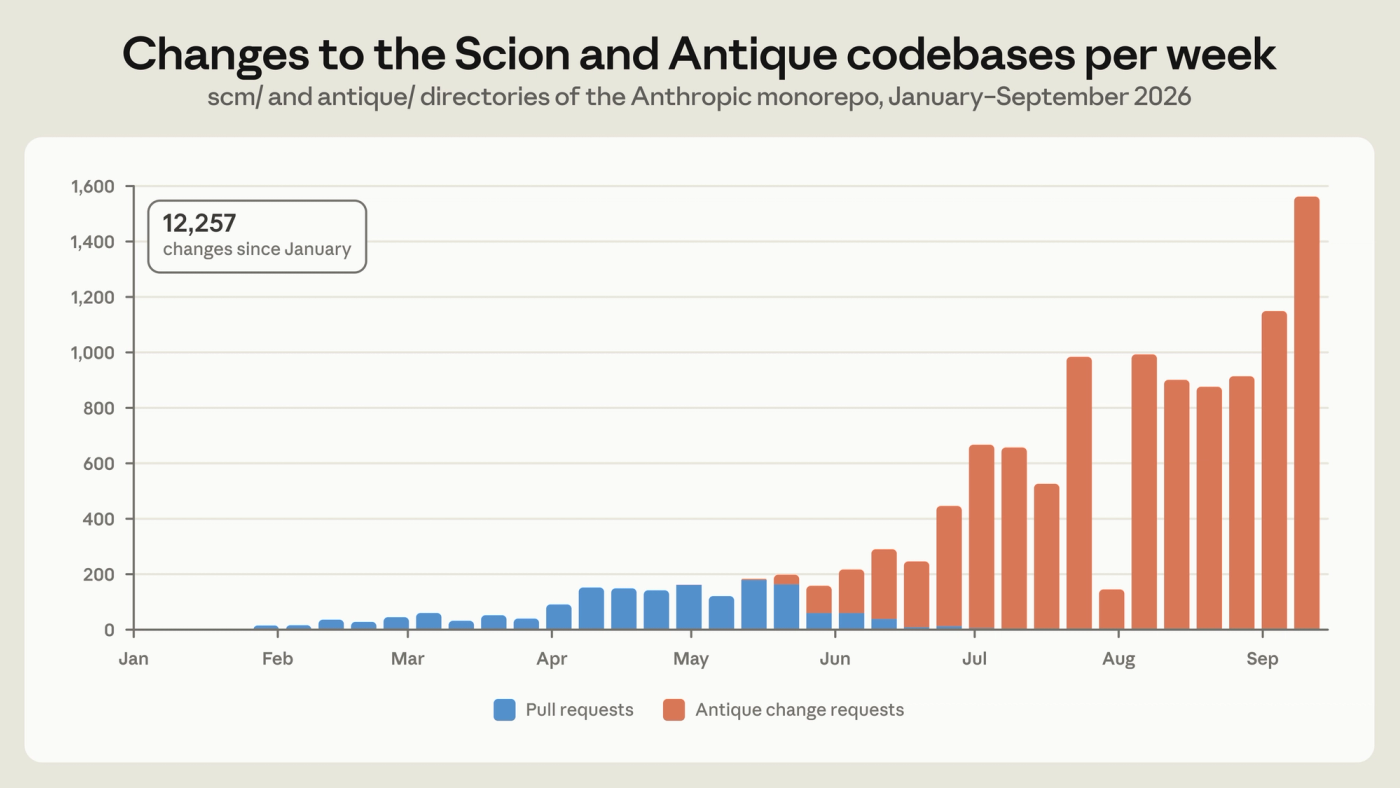
Cambios integrados por semana en las bases de código de Scion y Antique. Imagen: Anthropic.
El rol humano cambió de forma, no de valor. Los ingenieros del equipo hoy calificarían a Claude como mejor que ellos escribiendo código, pero siguen aportando lo que no se delega: el entendimiento de los componentes y sus interacciones, los compromisos de diseño y la escala que se sabía necesaria. El resumen del post es memorable: «muy a menudo, el papel de los ingenieros era decir "no" a Claude». Los agentes, explican, a veces violan restricciones centrales del sistema para satisfacer una regla que jamás debió permitirse: varios sistemas intentaron, por fuerza bruta, averiguar cuándo un cambio se integró a main leyendo linealmente el log de commits en vez de consultar la herramienta de revisiones. Y la revisión adversarial, que la empresa usa con intensidad, puede volverse miope: hubo revisiones que añadieron validación y complejidad excesivas ante preocupaciones hipotéticas. Hoy los humanos revisan cada solicitud de cambio, pero examinan la intención del cambio, ya no cada línea de código.
Hasta la operación del sistema se apoya en Claude: el equipo corre «superfans», instancias de Claude Tag con la tarea obsesiva de vigilar la salud de un único componente — uno para scion-daemon, otro para scion-cache, otro para la cola de merges de Antique —, con acceso a la telemetría y los logs, detectando asuntos sutiles ante los que los alertas tradicionales parecen unidimensionales. Y hasta el CI fue replanteado: a esta escala, la cola de merges con bloqueo global del repositorio, práctica estándar de la industria, dejó de tener sentido, porque cientos o miles de cambios se integran mientras los tests corren. El peso se movió a pruebas automatizadas posteriores a la integración y previas al despliegue; los conflictos concurrentes, dicen, los corrige Claude más rápido de lo que un humano los identificaría.
Qué gana realmente una gran empresa con Scion
El diseño no es exótico: es una apuesta coherente para otra clase de escala. A nuestro juicio, estas son las ventajas reales que una gran organización puede esperar de este enfoque:
- La velocidad del ciclo se vuelve la ventaja competitiva. Cuando el checkout toma segundos y las preguntas del repositorio se resuelven por API, el retardo entre «romper algo» y «saberlo» se derrumba, y los pipelines de bisect o revert, inviables a mano, se automatizan sin fricción. Eso solo se materializa donde el volumen diario es masivo y repetitivo: la empresa que gana es la que tiene 25 millones de checkouts al día, no la que tiene cuatrocientos a la semana.
- La eficiencia de infraestructura se mide en factura, no en benchmark. Pasar de varios cientos de espejos de Git a una pirámide de cachés 200 veces más pequeña multiplica el ahorro por cada trabajo que antes esperaba minutos: en un monorepo corporativo con miles de agentes y tareas, la suma se vuelve medible mes a mes, no en teoría.
- El repositorio como plataforma de producto. Con las API comprehensivas de Scion, la seguridad por carpeta, la revisión semántica de aprobaciones y la trazabilidad por directorio quedan al alcance de un RPC, no como proyectos paralelos. Distinguir un cambio de solo comentarios de un cambio de lógica crítica, y proteger los directorios más sensibles sin perder los beneficios del monorepo, es exactamente lo que una empresa grande necesita para escalar la calidad sin escalar el cuerpo de revisores.
- Preparación para un problema que ya está en el horizonte. Anthropic prevé que esta clase de desafíos será común en los próximos 6 a 12 meses. Una organización que hoy despliega agentes y automatiza la escritura de código obtiene de esta nota el mapa de la arquitectura que resiste ese crecimiento, con tiempo de reaccionar.
En resumen: una gran empresa no adopta este diseño por moda, sino porque su modelo de infraestructura cambia de signo cuando la mayoría del código lo escriben agentes, el CI es el mayor consumidor del repositorio y el costo del tiempo de espera del ciclo de integración define el ritmo real de la organización.
Por qué a los desarrolladores y empresas estándar no les serviría
Dicho sin crueldad: Scion no es mejor que Git, es diferente para un problema que casi nadie tiene. El propio post lo reconoce sin rodeos:
- El trabajo offline es una función, no un legado. Para el desarrollador en su laptop, en un avión, sin VPN o con mala conexión, la copia completa local de Git es exactamente la herramienta correcta. Scion abandona eso deliberadamente: sin conexión permanente al servidor, simplemente no funciona. Cuando el uso del repositorio es individual, la asimetría cliente-servidor es una regresión, no una mejora.
- Su problema no es tu problema. Solo brilla en monorepos gigantes, con decenas de miles de ingenieros o enjambres de agentes escribiendo código a diario. Para el equipo de cinco a veinte personas con servicios normales, los cuellos de botella que Scion resuelven quedan a dos órdenes de magnitud de distancia; migrar sería un costo puro sin contrapartida.
- No es un producto: es una pila entera. Adoptar Scion implica reemplazar todas las piezas del ciclo de vida: la revisión de código (Antique, a medida), la búsqueda de código, el CI y sus herramientas. Los componentes de Anthropic son tan a medida que ni siquiera ellos consideran útil una versión pública «que intente agradar a todos». El costo de migración es alto y completo, no parcial.
- Anclado a un proveedor de nube. Scion se apoya en Spanner, un servicio de Google Cloud. Atar el corazón de la plataforma de desarrollo a un proveedor concreto, con precios de cómputo y transferencia que solo se justifican con un consumo desbordante, deja de ser una decisión sensata para el promedio de la industria.
- No es libre. No hay versión pública, ni soporte, ni forks. Lo que Anthropic ofrece es el razonamiento, no un sistema instalable: para cualquier otra organización, «Scion» hoy es un borrador de arquitectura, no una herramienta.
- La comunidad de Git pesa más que la tuya. El propio post reconoce casi dos décadas del ecosistema escalando para millones de desarrolladores: plugins, hosting, clientes gráficos, todo gira en torno a Git. Renunciar a eso a cambio de checkouts más rápidos solo tiene sentido si el costo de la espera se mide en millones de dólares al mes.
Nuestra conclusión
Scion no compite con Git: define la frontera del siguiente problema de la ingeniería de software — qué pasa cuando la infraestructura pensada para humanos ya no sostiene un desarrollo conducido por agentes. La clave del diseño es una combinación que Git nunca ofreció: todo en el servidor, todo por API, todo caché de objetos inmutables. Por eso mismo, la contribución de Anthropic no es un producto sino una hoja de ruta: ya existen clones open source del diseño — como graft y OpenScion — midiendo en benchmarks cuánto se puede replicar sin la pila completa, y la propia Anthropic llama a plataformas como GitHub y GitLab y a la comunidad de código abierto a llevar ideas como los RPC comprehensivos de lado servidor al propio Git. La pregunta del próximo año no será «¿debemos abandonar Git?», sino «¿cuánto de este diseño podemos extraer sin abandonar Git?».
Para el desarrollador individual y la empresa mediana, la lección práctica es la escala: si algún día su organización mide su trabajo en checkouts de CI por minuto y los agentes son la mayoría de los clientes del repositorio, los principios de Scion serán la agenda de diseño que convenga leer primero. Entre tanto, Git sigue siendo la herramienta correcta para casi todos, y esta nota sirve como una anticipación fundada de hacia dónde puede ir todo si los números de su organización empiezan a parecerse a los que protagonizan esta historia.